La traduzione genica è un processo fondamentale della biologia molecolare attraverso il quale l’informazione genetica contenuta nell’RNA messaggero (m-RNA) è convertita in una sequenza specifica di amminoacidi, dando origine a una catena polipeptidica che, dopo opportuni processi di maturazione strutturale, diventerà una proteina funzionale. Questo meccanismo rappresenta la fase conclusiva dell’espressione genica e costituisce il punto in cui il flusso dell’informazione biologica si realizza in una funzione concreta all’interno della cellula.
La traduzione genica si basa su un sistema altamente organizzato e conservato evolutivamente, che consente di decodificare il linguaggio a quattro basi dell’RNA nel linguaggio a venti amminoacidi delle proteine. Tale conversione avviene secondo il codice genetico, un sistema di corrispondenza basato su triplette nucleotidiche chiamate codoni, ciascuna delle quali specifica un particolare amminoacido o un segnale di inizio e terminazione.
Il processo avviene nei ribosomi, complessi macromolecolari costituiti da RNA ribosomiale (r-RNA) e proteine, che agiscono come piattaforme catalitiche e funzionali per l’assemblaggio delle proteine. La traduzione richiede inoltre la cooperazione di diverse molecole accessorie, tra cui l’RNA transfer (t-RNA), che funge da adattatore molecolare tra codoni dell’mRNA e amminoacidi corrispondenti.
Insieme alla trascrizione genica, la traduzione genica rappresenta uno dei due passaggi fondamentali attraverso cui l’informazione contenuta nel DNA viene espressa. Essa costituisce quindi un elemento centrale del flusso dell’informazione genetica, che permette alle cellule di sintetizzare le proteine necessarie al proprio funzionamento, alla crescita e alla risposta agli stimoli interni ed esterni.
Ruolo dei ribosomi
La traduzione genica avviene nei ribosomi, complessi ribonucleoproteici costituiti da RNA ribosomiale (r-RNA) e proteine. Essi possono trovarsi liberi nel citoplasma oppure associati al reticolo endoplasmatico rugoso nelle cellule eucariotiche.
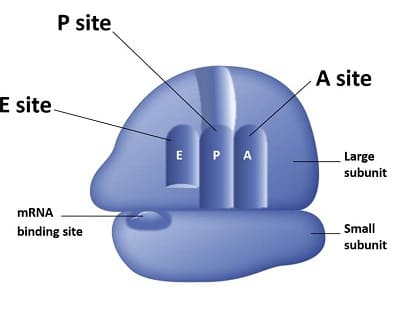
struttura del ribosoma
I ribosomi svolgono la funzione di leggere la sequenza dell’m-RNA e tradurla in una sequenza ordinata di amminoacidi secondo il codice genetico, che stabilisce la corrispondenza tra codoni (triplette di nucleotidi) e specifici amminoacidi.
Inizio della traduzione genica nei procarioti ed eucarioti
Nei procarioti, la traduzione inizia quando il ribosoma si lega a una sequenza specifica dell’mRNA chiamata sito di legame ribosomiale (RBS), localizzata in prossimità del codone di inizio (AUG).
Negli eucarioti, il processo è più complesso: il ribosoma riconosce il 5’ cap dell’m-RNA e scorre lungo la regione non tradotta 5’ (5’ UTR) fino a individuare il codone di inizio. Questo meccanismo consente un controllo più accurato dell’avvio della sintesi proteica.
Assemblaggio del complesso di inizio
L’avvio della traduzione richiede la presenza di specifici fattori di inizio, proteine che facilitano l’assemblaggio del ribosoma sull’m-RNA.
La subunità ribosomiale piccola si lega per prima all’m-RNA, seguita dalla subunità grande, formando il complesso funzionale attivo. All’interno del ribosoma sono presenti tre siti funzionali: A (amminoacilico), P (peptidilico) ed E (exit), che regolano il passaggio dei tRNA durante la sintesi proteica.
Il processo di inizio si completa quando il codone di start AUG, codificante per la metionina, si posiziona nel sito P, stabilendo il corretto quadro di lettura.
Fase di allungamento
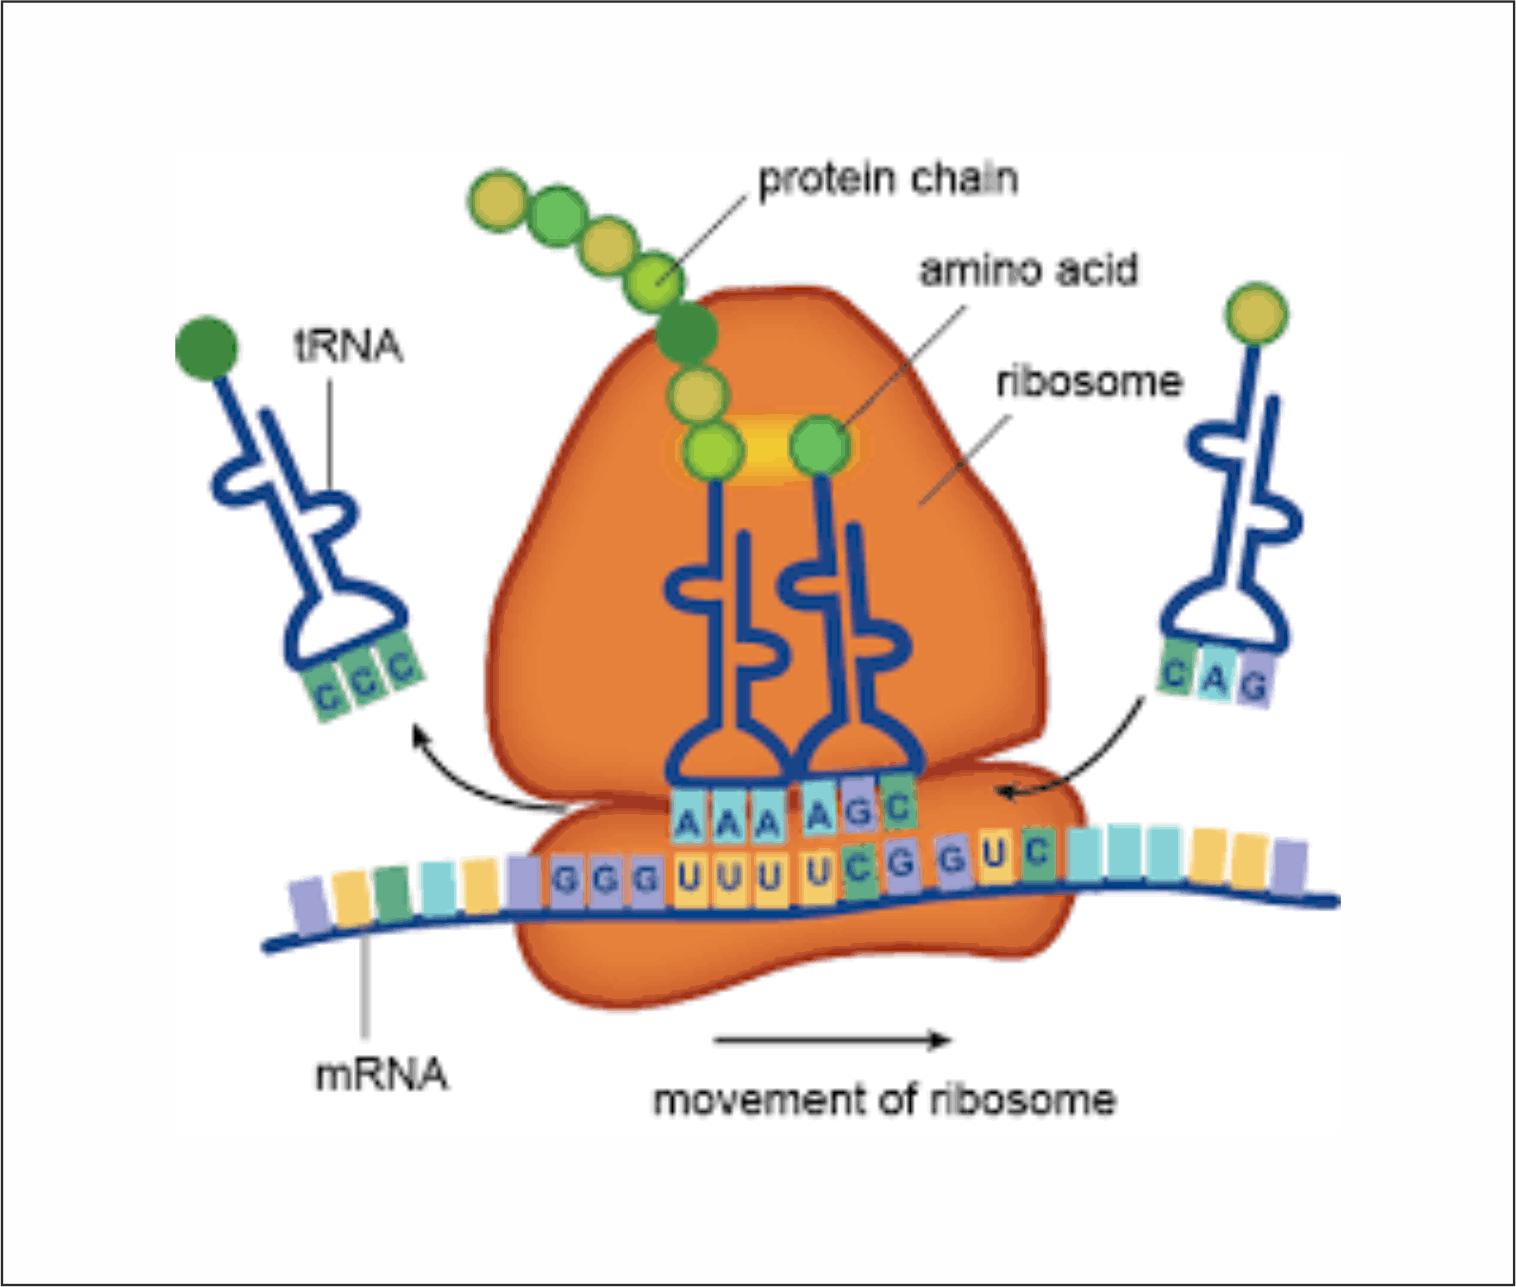
Durante la fase di allungamento, il ribosoma avanza lungo l’mRNA in direzione 5’ → 3’, leggendo i codoni successivi.
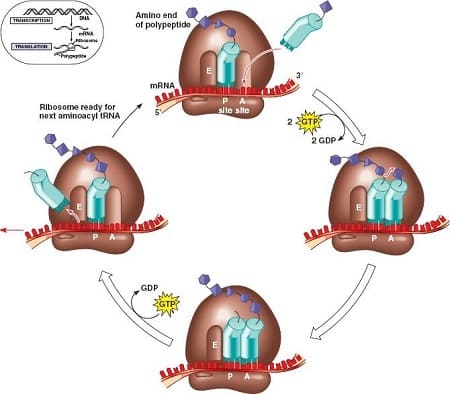
allungamento nella traduzione genica
Ogni codone esposto nel sito A viene riconosciuto da un RNA transfer (t-RNA) dotato di un anticodone complementare e carico dello specifico amminoacido. Il corretto appaiamento tra codone e anticodone garantisce la precisione del processo.
La formazione del legame peptidico tra l’amminoacido nel sito P e quello nel sito A consente l’allungamento della catena polipeptidica. Successivamente, il ribosoma trasloca di un codone: il tRNA nel sito P si sposta nel sito E ed esce dal ribosoma, mentre quello nel sito A passa nel sito P.
Questo ciclo si ripete in modo altamente efficiente, permettendo la sintesi rapida e precisa delle proteine.
Fase di terminazione
La traduzione termina quando il ribosoma incontra uno dei codoni di stop sull’m-RNA. In questo caso non esistono t-RNA corrispondenti, ma intervengono fattori di rilascio, che riconoscono il segnale di terminazione.
I fattori di rilascio favoriscono il distacco della catena polipeptidica e la dissociazione del complesso ribosomiale, liberando l’mRNA e le subunità ribosomiali.
Dal polipeptide alla proteina funzionale
trasferimento dell’informazione genica
Il prodotto finale della traduzione genica è una catena polipeptidica, che non è ancora biologicamente attiva. Essa deve infatti subire processi di ripiegamento tridimensionale (folding) e, in molti casi, modificazioni post-traduzionali, come fosforilazione o glicosilazione, che ne determinano la struttura e la funzione definitiva.
La traduzione genica rappresenta il passaggio finale del flusso dell’informazione genetica, trasformando il linguaggio dei nucleotidi dell’m-RNA nel linguaggio delle proteine. Questo processo, altamente regolato e conservato evolutivamente, è essenziale per la vita cellulare e per la corretta espressione del patrimonio genetico.
Ruolo del t-RNA nella traduzione genica
Il RNA transfer (t-RNA) svolge un ruolo essenziale nella traduzione genica, poiché rappresenta la molecola che mette in relazione il linguaggio degli acidi nucleici con quello delle proteine. In altre parole, il t-RNA agisce come adattatore molecolare, traducendo le informazioni codificate nell’RNA messaggero (m-RNA) in una sequenza specifica di amminoacidi.
Ogni molecola di t-RNA possiede una struttura tridimensionale caratteristica che le consente di svolgere questa funzione. In una sua estremità si trova un anticodone, una tripletta di nucleotidi complementare a un codone dell’m-RNA, mentre all’estremità opposta è presente il sito di legame per uno specifico amminoacido. Questa doppia specificità permette al t-RNA di garantire la corretta corrispondenza tra codone e amminoacido durante la sintesi proteica.
Caricamento
Il caricamento del t-RNA con il corretto amminoacido avviene grazie all’azione di enzimi specifici chiamati amminoacil-tRNA sintetasi, che riconoscono simultaneamente sia il t-RNA sia il corrispondente amminoacido. Questo passaggio è fondamentale per assicurare l’accuratezza della traduzione, poiché un errore di caricamento comporterebbe l’inserimento di un amminoacido errato nella catena polipeptidica.
Allungamento
Durante la fase di allungamento della traduzione, il t-RNA entra nel ribosoma e si posiziona nel sito A quando il suo anticodone è complementare al codone presente sull’mRNA. Successivamente, il ribosoma catalizza la formazione del legame peptidico tra l’amminoacido trasportato dal -tRNA e la catena polipeptidica in crescita. Dopo il trasferimento dell’amminoacido, il t-RNA privo del suo carico si sposta nel sito E ed esce dal ribosoma, permettendo l’ingresso di un nuovo -tRNA.
In questo modo, il t-RNA garantisce la precisione, la continuità e l’efficienza della traduzione genica, rendendo possibile la corretta sintesi delle proteine a partire dall’informazione genetica contenuta nell’mRNA.
Dal polipeptide alla proteina funzionale
Il polipeptide neosintetizzato
Il prodotto immediato della traduzione genica è una catena polipeptidica lineare, costituita da una sequenza specifica di amminoacidi determinata dall’informazione contenuta nell’mRNA. In questa fase iniziale, la molecola non possiede ancora una struttura tridimensionale stabile né attività biologica, e non può quindi essere considerata una proteina funzionale.
Il ripiegamento tridimensionale della proteina
Per acquisire funzionalità, il polipeptide deve subire il processo di ripiegamento proteico (protein folding), attraverso il quale la catena assume una precisa conformazione tridimensionale. Questa struttura è stabilizzata da interazioni tra i gruppi laterali degli amminoacidi, come legami idrogeno, interazioni idrofobiche e legami ionici.
Il corretto ripiegamento è fondamentale per la funzione della proteina, poiché determina la formazione di siti attivi e domini funzionali specifici. In molti casi, il processo è assistito da proteine specializzate chiamate chaperoni molecolari, che favoriscono il corretto assemblaggio della struttura e impediscono aggregazioni non funzionali.
Le modificazioni post-traduzionali
Dopo il ripiegamento, molte proteine subiscono ulteriori trasformazioni chimiche note come modificazioni post-traduzionali. Queste modifiche possono includere processi come fosforilazione, glicosilazione e acetilazione, che influenzano l’attività, la stabilità e la localizzazione della proteina all’interno della cellula.
Tali modificazioni rappresentano un importante livello di regolazione funzionale, poiché permettono di modulare l’attività proteica in risposta a segnali intracellulari ed extracellulari.
Attivazione della proteina e funzione biologica
Solo al termine di questi processi il polipeptide diventa una proteina funzionale, in grado di svolgere specifiche attività biologiche. Le proteine mature possono avere ruoli diversi all’interno della cellula, come funzioni enzimatiche, strutturali, di trasporto o regolatorie, contribuendo in modo essenziale al corretto funzionamento dell’organismo.
In sintesi, la trasformazione dal polipeptide alla proteina attiva rappresenta la fase finale della traduzione genica e costituisce un passaggio fondamentale per la realizzazione dell’informazione genetica.
Errori durante la traduzione genica
Possibilità di errore nel processo di traduzione
Durante la traduzione genica possono verificarsi errori, anche se il processo è generalmente caratterizzato da un’elevata precisione. Tali errori consistono principalmente nell’inserimento di un amminoacido non corretto nella catena polipeptidica in formazione, con conseguente alterazione potenziale della sequenza proteica.
Origine degli errori
Gli errori possono derivare da due principali livelli del processo. Il primo riguarda un possibile appaiamento non corretto tra codone dell’m-RNA e anticodone del t-RNA all’interno del ribosoma. Il secondo è legato a un’errata associazione tra amminoacido e t-RNA da parte delle amminoacil-tRNA sintetasi, enzimi responsabili del caricamento corretto del t-RNA.
Meccanismi di controllo della fedeltà
La cellula possiede diversi sistemi che riducono la frequenza degli errori. Il ribosoma contribuisce alla selezione accurata dei t-RNA compatibili, mentre le amminoacil-tRNA sintetasi dispongono spesso di meccanismi di correzione (editing enzimatico) che eliminano amminoacidi non correttamente associati. Questi controlli rendono la traduzione un processo altamente fedele, pur non essendo completamente privo di imprecisioni.
Conseguenze funzionali degli errori
Le conseguenze di un errore di traduzione dipendono dalla natura della sostituzione amminoacidica e dalla regione della proteina coinvolta. In molti casi, l’effetto è minimo o nullo, soprattutto se l’amminoacido sostituito possiede proprietà chimiche simili a quello corretto. In altri casi, invece, la modifica può alterare la struttura tridimensionale della proteina e comprometterne la funzione biologica.
Significato biologico
Gli errori di traduzione sono temporanei e non ereditabili, poiché riguardano esclusivamente la singola molecola proteica e non modificano l’informazione genetica contenuta nel DNA. Nonostante ciò, il basso tasso di errore rappresenta un compromesso funzionale tra rapidità del processo e accuratezza della sintesi proteica.
Conclusione
La traduzione genica rappresenta uno dei processi fondamentali della biologia molecolare, attraverso il quale l’informazione contenuta nell’RNA messaggero è convertita in una proteina funzionale. Questo meccanismo costituisce la fase finale dell’espressione genica e realizza concretamente il flusso dell’informazione genetica all’interno della cellula.
Nel suo insieme, la traduzione è un processo altamente organizzato e coordinato, che coinvolge il ribosoma, il t-RNA e numerosi fattori proteici. La sua elevata precisione consente la sintesi corretta delle proteine, pur mantenendo una velocità sufficiente a soddisfare le esigenze cellulari.
La presenza di meccanismi di controllo e la possibilità di errori rari ma gestiti evidenziano il delicato equilibrio tra efficienza e accuratezza che caratterizza i sistemi biologici. Inoltre, le fasi successive alla traduzione, come il ripiegamento proteico e le modificazioni post-traduzionali, sottolineano come la formazione di una proteina funzionale sia un processo complesso e multilivello.
In conclusione, la traduzione genica non rappresenta soltanto un passaggio tecnico della sintesi proteica, ma un elemento centrale che consente la realizzazione dell’informazione genetica e, di conseguenza, il funzionamento stesso degli organismi viventi.

